Буквально на днях обсуждали с ментисом является ли нормальной практикой делать классификацию с помощью генеративных моделей, например, классификацию E-mail’ов SPAM/NOT_SPAM или классификацию тикетов в вашей Jira, моё мнение – очень часто это имеет смысл, – особенно когда множество классов у нас не статично и условия будут вынуждать нас перетренировывать BERT’а каждый раз когда добавляется новый критерий или класс.
Если упростить, то BERT у нас натренирован заполнять [MASKED] места в тексте тем, что туда подходит лучше всего основываясь на контексте с обеих сторон:
Пример:
Я люблю [MASKED] кофеGPT работает, что называется авторегрессивно – умное слово означающее, что вероятность генерации токена зависит от всех токенов, сгенерированных ДО него:
Я люблю пить → ?Поздравляю, вы прошли курс молодого эмэмльщика, теперь вы знаете из каких двух частей состоит архитектура Трансформер.
BERT – это так называемый encoder (переводит input в вектор, эмбеддинг если хотите), поверх его представлений о тексте тренируется простенькая нейронка, которая, основываясь на этих эмбедингах решает как классифицировать входящий в BERT текст по тем параметрам, которые выбираете вы во время тренинга этой нейронки. Отсюда и появляется его способность к классификации – BERT + mini-нейронка.
По вышеизложенному примеру можно догадаться, что BERT может предсказывать все замаскированные позиции параллельно -> это намноооого быстрее, чем генерировать токены один за другим и делать классификацию на основе сгенерированного резонинга.
Так почему же мы с вами пользуемся ChatGPT, а не ChatBERT? На это есть несколько причин:
- У генеративных моделей нет необходимости в fine-tuning под каждую задачу, in-context learning решает всё за нас.
- GPT легче тренировать на тексте из Интернета.
- GPT-only архитектура лучше масштабировалась
- …
Если у вас хватило духа всё это прочитать, то поздравляю, вас прогрели на то, чтобы вы изучили что такое JEV. Jev – новый класс моделей от ноунейм-компании Typesafe, основатель которой придумал Instruct GPT – этот концепт я объяснял тут.
Мы не знаем настоящюю архитектуру JEV, но если очень сильно упростить, JEV – это как если бы BERT + mini-нейронка которая научились понимать описание классов из промпта, и их больше не надо перетренировывать каждый раз когда что-то меняется.
Он даже confidence_score настоящий возвращает и теперь не нужно спрашивать у GPT “верни число от 1 до 10 на сколько ты уверен в своём ответе”, если вдруг кто-то всё ещё этим занимался 😅
JEV не галлюционирует, это невозможно из-за того, что устроен он как BERT, – мы засовываем в него JSON схему, а он лишь заполняет пустые [MASKED] места параллельно, ему не надо переписывать всю вашу схему с нуля, чтобы вернуть ответ, поэтому и скорость у него на два порядка быстрее.
Давайте сравним прайсинг Jev с моделями которые раньше использовали для подобных задач:
| Модель | Input / 1M tokens | Output / 1M tokens |
|---|---|---|
| Jev | $0.042 | $0 |
| GPT-5.4 nano | $0.20 | $1.25 |
| GPT-5.6 Luna | $0.20 | $1.20 |
| Claude Haiku 4.5 | $1.00 | $5.00 |
| Gemini 3.8 Flash | $0.75 | $3.75 |
Как вы можете заметить, тут не о чем и говорить, НО это не значит, что JEV теперь будет королём. Просто раньше мы использовали генеративки там где, очевидно, лучше подошли бы модели по типу JEV и теперь мы естественным образом произведём миграцию на Jev как только он будет stable-release и мы убедимся, что его “когнитивные способности” в плане классификации ничем не уступают генеративкам.
Это действительно большой шаг в правильную сторону, ожидаю увидеть модели гибридного типа Jev-like классификатор + GPT-like reasoner. JEV не предназначен для длинного последовательного reasoning’а. TypeSafe прямо рекомендует декомпозировать сложные решения на набор атомарных вопросов и собирать дальнейшую логику кодом.
Также, если вы будете использовать его, скажем, для принятия решения о том, какой вызвать tool, то он вам даже не подскажет какие аргументы туда нужно передать, это уже придётся спрашивать у генеративки.
Я доступ к Jev уже получил, вы можете подать заявку тут. Вот первый пример который я попробвал:
r = TypeSafeClient().system_one(
    state={
        "state": "Я не хочу верить результатам электорального процесса, я устал, босс, мне очень больно!"
    },
    questions={
        "urgency": Noul(
            instructions="Насколько срочно человеку нужна помощь?"
        ),
        "mood": Choice(
            instructions="В каком настроении пребывает человек?",
            criteria={
                "sadness": "чувство утраты, скорби или разочарования",
                "desperate": "чувство безнадёжности",
                "neutral": "нейтрально, ни рыба ни мясо",
            },
        ),
    },
)

print(r.nouls["urgency"].noul)
print(r.choices["mood"].choice)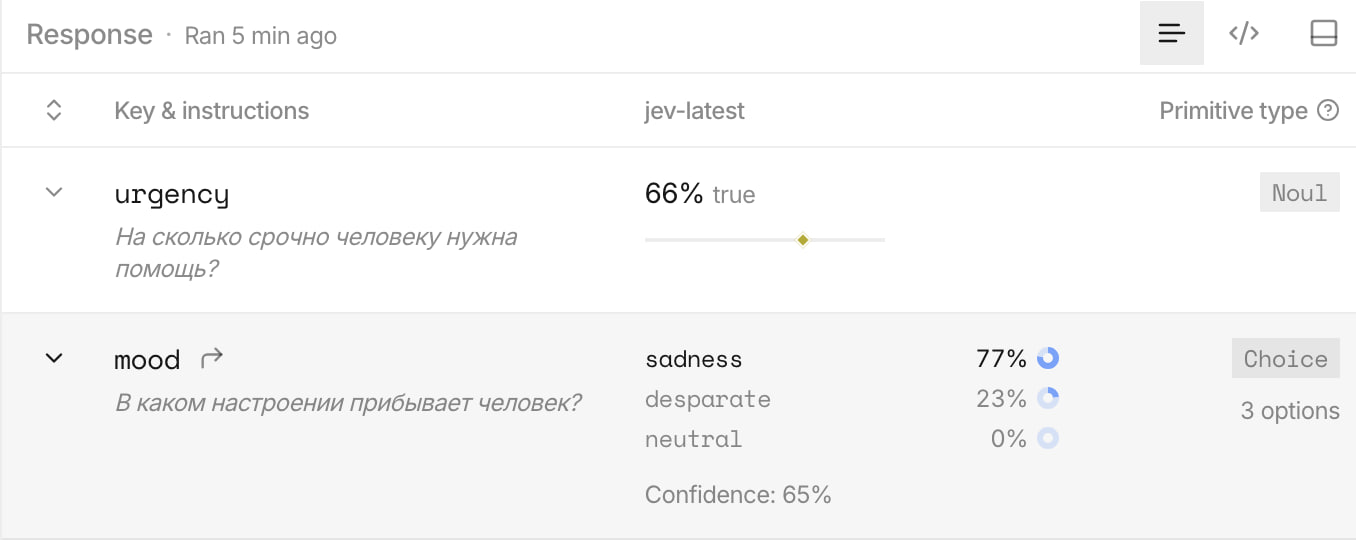
Короче, хайп оправданный, наконец-то какая-то движуха началась, а то я уже не знал чем я буду заниматься… Больше всего ждём открытых моделей подобного класса от китайцев, уж очень интересно узнать, что там внутри и есть ли там вообще BERT или это совсем что-то новое…
Про JEV сейчас трубит весь англоязычный интернет, и не зря, если вы погружены в AI тематику и это первый пост на русском языке про JEV который вы читаете, то перешлите это в ваши AI чатики и цените, у всех пост про JEV выйдет позЖЕ, а в моей Багодельне уЖЕ.

